 E&M Next Blog
Cómo funcionan los modelos de lenguaje (LLM), explicado simple
En el artículo anterior dejamos pendiente la pregunta más interesante: ¿cómo hace un modelo de lenguaje para sostener una conversación, escribir código o explicar un concepto, si "por dentro" solo está prediciendo palabras? La respuesta corta es: practicando esa predicción miles de millones de veces, sobre una cantidad de texto que ningún humano podría leer en mil vidas.
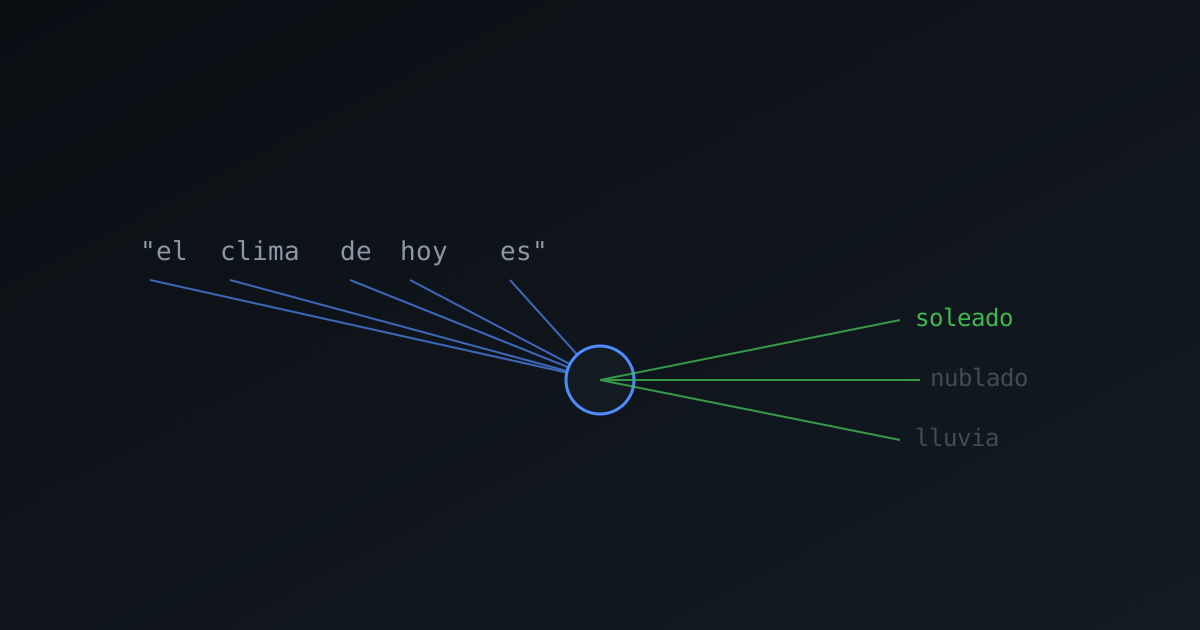
El juego de adivinar la siguiente palabra
Un LLM se entrena con un ejercicio aparentemente tonto: le muestras un fragmento de texto, le tapas la última palabra, y le pedís que adivine cuál es. Al principio adivina mal, casi al azar. El sistema compara su predicción con la palabra real, ajusta internamente millones (o billones) de parámetros numéricos para equivocarse un poco menos la próxima vez, y repite el proceso con el siguiente fragmento. Y con el siguiente. Miles de millones de veces.
De ese proceso de ajuste repetido emerge algo que nadie programó explícitamente: el modelo "descubre" que para predecir bien necesita captar gramática, hechos del mundo, relaciones de causa y efecto, y patrones de argumentación. No porque alguien se lo haya enseñado como reglas, sino porque esas regularidades son justamente lo que hace que una predicción sea buena en vez de aleatoria.
De "predecir texto" a "sostener una conversación"
Ahí está el salto que más confunde a la gente. Un modelo entrenado solo para predecir texto seguiría, ante "Escribe una receta de arroz", completando con más texto de recetas — no necesariamente respondiendo a vos de forma útil. Por eso hay un segundo paso de entrenamiento, llamado ajuste por instrucciones (instruction tuning) y refuerzo con retroalimentación humana (RLHF): personas evalúan miles de respuestas del modelo y le enseñan cuáles son útiles, honestas y seguras, y cuáles no. Ese segundo paso es el que convierte un "completador de texto" en un asistente que responde preguntas.
Tokens, no palabras
Un detalle técnico que vale la pena conocer: el modelo no trabaja con palabras completas, sino con fragmentos llamados tokens (a veces una palabra, a veces un pedazo de ella). "Inteligencia" podría dividirse en "Intel" + "igencia", por ejemplo. Esto explica cosas prácticas: por qué el costo de usar un modelo se mide en tokens, por qué a veces falla contando letras dentro de una palabra (ve tokens, no letras), y por qué un texto en español puede "costar" más tokens que el mismo texto en inglés.
¿Por qué entonces "alucina"?
Si el entrenamiento premia predecir texto plausible, el modelo no tiene un mecanismo interno que distinga "esto lo sé con certeza" de "esto suena bien pero lo estoy inventando". Ambos casos activan el mismo proceso de predicción. Por eso un LLM puede inventar una cita, una fecha o una función de una librería con total fluidez y total seguridad en el tono — no porque "mienta", sino porque generar la respuesta plausible es literalmente su única tarea.
Entender esto cambia cómo deberías usarlo: para generar un primer borrador, resumir, explicar un concepto o reformular una idea, es extraordinario. Para afirmar un dato puntual y verificable sin chequearlo después, es el lugar equivocado para confiar ciegamente.
Lo que viene
Con esta base, el siguiente paso natural es entender la diferencia entre esta IA que genera texto, imágenes o código, y la IA más "clásica" que clasifica o predice sobre datos estructurados — que es justo el tema del próximo artículo.
¿Tu empresa necesita algo así?
En E&M Next diseñamos e implementamos soluciones de IA, automatización y producto digital a medida.
Hablemos de tu proyecto